최근 확실히 전 세계 서버용 NVIDIA GPU가 수급난에 있는 듯하다.1 (미국 하이퍼스케일러 A사 등등 포함)2 NVIDIA에서 Blackwell, GB 같은 차세대 아키텍처를 내놓으면서 사실상 이전 세대의 추가 공급이 거의 단절되다 보니 생긴 현상이다. 하지만 FlashAttention처럼 Hopper에 맞춰 최적화해온 커뮤니티 프로젝트들이 많고, 다음 세대 아키텍처에서 같은 성능을 내려면 포팅과 검증에도 시간이 필요하다. 그러니 foundation model 학습과 추론에 널리 쓰이는 H100, H200의 수요는 여전할 수밖에 없고, 돈을 내고 쓰려고 해도 원하는 물량이 안 잡힐 때가 생기는 것.
하지만 중국을 필두로 커뮤니티에는 고품질 오픈소스가 계속해서 커뮤니티에 풀리고 있고, 이로 인해 Hopper GPU에 대한 수요도 여전히 높다. (1) 학습 측면에서는 요즘 소버린 AI에 대한 이야기도 많지만, 자체 모델 개발 (성능 최적화를 위한 파인튜닝 및 아키텍처 트위킹)에 대한 니즈는 언제나 존재해왔고.. (2) 추론 측면에서는 vLLM, SGLang 같은 오픈 프레임워크가 너무 잘 돼 있으니 (물론 여느 오픈소스가 그렇듯이 잘 다루려면 엔지니어링 에포트가 많이 필요하다) 토큰 비용 절감을 위해 오픈모델을 자체 서빙하려는 니즈도 계속 생겨나고 있다. H100, H200이 품귀된 현시점 대안은 없을까 하고 고민하던 중 문득 중국에 공급되던 H20 GPU들은 어떻게 됐지? 생각이 불현듯 스쳤다.
카드 스펙부터 찾아보자
H20은 중국 시장을 대상으로 설계된 NVIDIA의 Hopper 계열 GPU다. NVIDIA의 실적 자료에서도 이를 확인할 수 있는데, 막상 카드 사양을 찾아보려니 H100이나 H200을 알아볼 때와는 조금 달랐다.
H100과 H200은 공식 제품 페이지에서 사양과 데이터시트로 바로 이어지는 반면, H20은 이번 조사에서 그에 해당하는 공개 페이지를 찾지 못했다. 중국향 제품이라는 배경은 있지만, 그것이 자료를 찾기 어려운 이유인지는 알 수 없다. 우선 NVIDIA의 지원 문서에서 모델 구성을 확인하고, 실제로 운영하는 팀이 공개한 기술 글을 함께 읽으며 사양을 맞춰봤다.
이렇게 확인한 메모리 사양을 모으면 아래와 같다. H100·H200은 NVIDIA의 공개 사양을 사용했고, H20 96GB의 대역폭은 Ant 운영팀이 공개한 비교표를 참고했다.
| GPU | 메모리 용량 | 메모리 대역폭 |
|---|---|---|
| H100 SXM | 80GB | 3.35 TB/s |
| H200 SXM | 141GB | 4.8 TB/s |
| H20 96GB | 96GB | 4.0 TB/s¹ |
| H20 141GB / H20-3e | 141GB | 이번 조사에서 확인하지 못함 |
출처: NVIDIA H100 사양·데이터시트, H200 사양·데이터시트, H20 공식 지원 문서, ¹Ant의 H20-96G 비교표.
여기서 눈에 들어오는 것은 연산 성능과 메모리 사양의 차이다. Ant의 비교표에 따르면 H20-96G의 BF16 연산 성능은 148 TFLOPS로, 함께 비교한 H800의 989 TFLOPS보다 훨씬 낮다. 그런데 메모리 용량과 대역폭은 오히려 더 크다. 연산 성능만 보고 넘어가기에는 조금 아쉬운 구성이고, 추론에서 이 메모리 특성을 얼마나 활용할 수 있을지가 궁금해지는 지점이다.
H20 96GB와 H20-3e 141GB
자료를 찾다 보니 H20 안에서도 구분할 것이 하나 더 있었다. 검색 결과에는 96GB 모델이 주로 보이는데, NVIDIA AI Enterprise 문서에는 H20 SXM5 96GB와 함께 H20 SXM5 141GB도 별도 모델로 올라와 있다.
이 141GB 모델을 GitHub에서는 H20-3e라고 부른다. 뒤에서 조금 더 살펴볼 vLLM PR #19205가 그 예인데, H20-3e가 141GB 메모리를 가진 H20이라고 설명하면서 DeepSeek MoE 모델용 튜닝 설정을 추가하고 있다.
이 글에서 직접 돌려볼 장비도 이 H20-3e다. 96GB 모델보다 메모리가 45GB 더 크니, 같은 모델 가중치를 올리더라도 KV cache에 쓸 수 있는 공간이 달라진다. 다만 용량이 다르다는 사실만으로 나머지 사양까지 알 수 있는 것은 아니어서, 96GB 모델의 연산 성능과 대역폭을 H20-3e의 수치로 쓰지는 않았다. 이후의 운영 사례도 어느 H20을 사용했는지 구분해서 읽을 필요가 있다.
Ant와 Alibaba는 어떻게 쓰고 있을까
Ant: prefill과 decode를 분리한 구성
사양만 놓고 추측하는 것보다 실제 운영 사례를 보면 조금 더 감이 온다. Ant가 2025년 9월 공개한 DeepSeek-R1 운영 글에서는 H20 96GB를 사용하면서 prefill과 decode를 분리했다. 입력을 읽는 prefill에는 한 노드의 GPU 8장을 묶는 TP8을, 토큰을 생성하는 decode에는 두 노드의 GPU 16장에 전문가를 나누는 EP16을 적용했다.
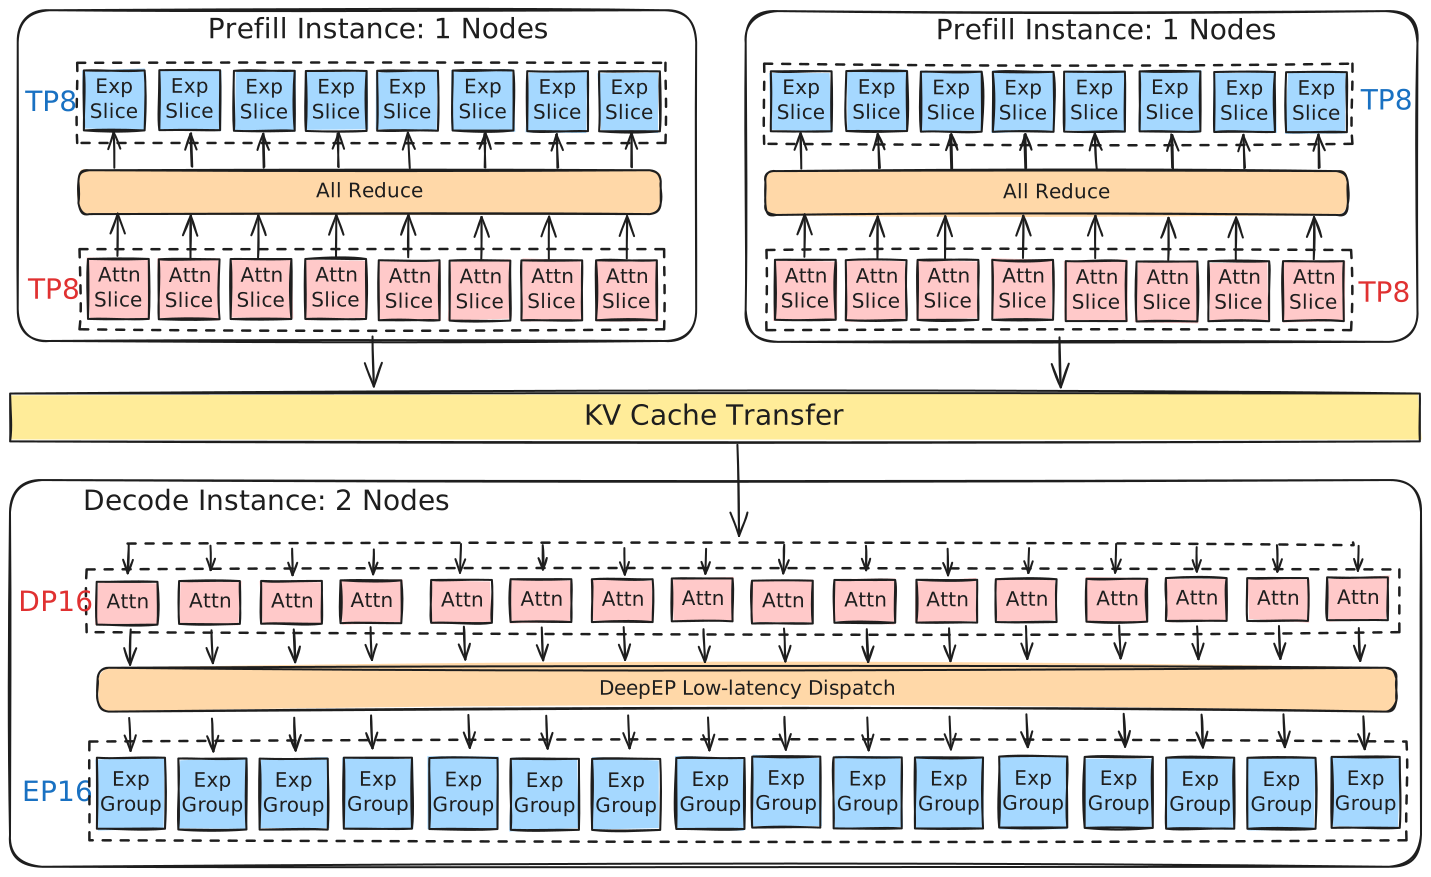
Ant가 공개한 배포 구성도. 위는 prefill, 아래는 decode다. 원문 도식.
같은 장비를 쓰더라도 서비스가 요구하는 응답 속도에 따라 설정은 달라졌다. 예를 들어 InferX Max는 첫 토큰까지 1초 미만, 이후에는 토큰당 30ms 미만을 목표로 두고 배치 크기와 추측 디코딩 설정을 조절했다. H20의 처리량을 얼마나 끌어올릴 수 있는지뿐 아니라, 사용자가 얼마나 기다려도 되는지를 함께 놓고 배포 구성을 정한 셈이다.
Alibaba: 여러 모델이 공유하는 GPU
Alibaba 쪽에서는 H20을 여러 모델이 나눠 쓰는 사례를 찾을 수 있었다. Aegaeon이라는 시스템인데, 요청이 드문 모델에도 GPU를 따로 붙여두면 자원이 남는다는 문제에서 출발한다. 이를 줄이기 위해 요청 하나가 모두 끝날 때까지 기다리는 대신, 토큰 생성 도중에도 모델에 할당한 자원을 바꿀 수 있도록 구성했다.
SOSP 2025 논문에는 Model Studio에서 3개월 넘게 베타 운영한 결과도 나온다. 1.8B부터 72B까지 47개 모델을 서빙하면서, 필요한 H20의 수를 1,192장에서 213장으로 줄였다고 보고한다. GPU 한 장이 빨라진 결과라기보다는 여러 모델이 자원을 공유하면서 유휴 시간을 줄인 결과로 읽는 것이 맞다. 이 운영 사례에서는 사용한 H20이 96GB인지 141GB인지까지는 명시하지 않았다.
두 사례를 함께 읽으면 H20을 이미 서비스에 넣어 쓰는 팀들이 어떤 부분에 손을 대고 있는지 보인다. Ant는 prefill과 decode의 특성에 맞춰 GPU 구성을 나눴고, Alibaba는 여러 모델이 GPU를 효율적으로 공유하는 쪽에 집중했다. 적어도 H20으로 추론 서비스를 운영하는 일이 낯선 실험만은 아니라는 점은 확인할 수 있었다.
GitHub에서 찾은 최적화 흔적
그렇다면 이런 운영 경험이 공개 코드에는 얼마나 반영돼 있을까. GitHub에서 H20을 검색해보면 단순히 실행이 된다는 보고를 넘어, 이 GPU에 맞게 커널 설정을 조정한 변경도 찾을 수 있다.
GitHub · vllm-project / vllm · #19205 ↗ Add H20-3e fused MoE kernel tuning configs for DeepSeek-R1/V3 “H20-3e is H20 GPU with 141G memory.” Merged · 2025-06-05 UTCvLLM PR #19205 · 원문 제목과 설명 발췌. H20-3e용 튜닝 설정을 추가한 변경.
앞서 H20-3e의 이름을 확인했던 vLLM PR #19205에는 실제 서빙 결과도 함께 올라와 있다. 기여자는 H20-3e 8장으로 DeepSeek-R1-0528을 돌렸고, MoE 설정을 조정한 뒤 출력 처리량이 194.15 tok/s에서 225.04 tok/s로 늘었다고 보고했다. 같은 장비에서 튜닝 설정을 바꿔 비교한 결과이며, 이 변경은 2025년 6월 5일(UTC) 병합됐다. PR에 실행 명령도 남아 있어 어떤 조건으로 측정했는지 함께 살펴볼 수 있다.
한편 SGLang PR #8722는 반대 방향에서 흥미롭다. H20에서 쓰던 FP8 행렬 연산을 H100·H200·H800에 적용했더니 성능이 떨어져, 이들 GPU에는 다른 스케줄을 적용한 변경이다. 같은 Hopper 계열이어도 연산 단계별로 걸리는 시간의 비중이 달라, 한 GPU에 맞춘 설정이 다른 GPU에서도 유리하다고 볼 수는 없었던 것이다. 이 PR은 2025년 8월 3일(UTC) 병합됐다.
이제 직접 돌려보자
여기까지 찾아보고 나니, 가지고 있는 H20-3e에서도 한번 확인해보고 싶어졌다. 우선 Qwen3-32B를 BF16으로 GPU 한 장에 올리고, 입력과 출력을 각각 512토큰으로 맞춘 뒤 요청을 하나씩 보내봤다. 비교할 H100·H200 수치는 같은 프로토콜로 측정한 Jarvislabs의 공개 결과를 가져왔다.
| GPU | 첫 토큰까지, TTFT p50 | 출력 처리량 |
|---|---|---|
| H20-3e | 260.7ms | 49.7 tok/s |
| H100 SXM | 58.5ms | 40.1 tok/s |
| H200 SXM | 56.3ms | 53.6 tok/s |
H20-3e는 자체 실험 집계값, H100·H200은 공개 측정값. 호스트 환경은 다르다.
첫 토큰을 받기까지 H20-3e에서는 H100보다 약 202ms를 더 기다려야 했다. 그런데 출력 처리량은 오히려 약 24% 높았고, 첫 토큰 이후의 토큰당 시간(TPOT)도 H100의 24.88ms보다 짧은 19.65ms였다. 응답을 시작하는 데는 시간이 더 걸렸지만, 일단 생성이 시작된 뒤에는 토큰을 더 빠르게 내보낸 것이다.
사양을 보면서 궁금했던 연산 성능과 메모리의 차이가 이 결과에서도 떠오른다. 입력을 처리하는 prefill과 토큰을 하나씩 이어 만드는 decode는 자원을 사용하는 방식이 다르고, 특히 작은 배치의 decode에서는 메모리 대역폭의 영향이 커질 수 있다. 이번 결과는 그 설명과 맞아 보이지만, 아직 프로파일링으로 병목을 확인한 것은 아니다. TTFT에는 prefill 외의 지연도 들어가고 출력 처리량에는 입력 처리 시간도 포함되므로, 두 지표를 각 단계의 성능과 그대로 대응시키기는 어렵다.
그러면 입력이 길어졌을 때는 어떨까. 짧은 질문 하나를 주고받을 때와 긴 문서 전체를 읽힌 뒤 답을 받을 때, H20-3e의 쓰임새는 꽤 다를 수도 있다. 다음 편에서는 입력을 512토큰에서 8,192토큰으로 늘려, 첫 토큰을 기다리는 시간이 얼마나 달라지는지와 짧은 입력에서 보였던 처리량의 이점이 여전히 남는지를 살펴보려 한다.
측정 메모: vLLM 0.29.0, Qwen3-32B BF16 가중치·KV cache, TP1, 조건별 32요청 × 3회. H20-3e는 제공된 자료 묶음 B2의 p50 집계값이며 개별 실행 JSON을 재집계하지 않았다. H100·H200은 고정 커밋의 원본 JSON에서 실행별 p50의 중앙값과 처리량 중앙값을 확인했다. 품질·비용은 측정하지 않았다. 상세 비교 프로토콜
Footnotes
-
Reuters의 중국 업체 GPU 주문 보도, 2026년 10월 20일. Tencent·Alibaba·ByteDance가 추론용 대체품으로 RTX PRO 5500을 300만 장 넘게 주문했다는 내용이다. 소식통은 요청량의 5~10%만 공급받을 수 있다는 안내를 받았다고 전했다. 이 보도는 중국의 수출 규제와 생산능력 배분이 겹친 사례다. ↩
-
Reuters, 「Amazon cloud capacity sold out through 2027, CEO Jassy says」, 2026년 10월 23일. Andy Jassy는 AWS의 2027년 대규모 클라우드 공급 물량이 대부분 예약됐고, 2028년 물량도 상당 부분 계약됐다고 밝혔다. 온디맨드와 Bedrock·EC2용 일부 용량은 남겨둔다고 덧붙였다. ↩